AI multimodal: cum înțelege inteligența artificială text, imagini, audio și video
Află ce înseamnă AI multimodal, cum analizează modelele text, imagini, audio și video, ce aplicații practice are și ce limite trebuie verificate.
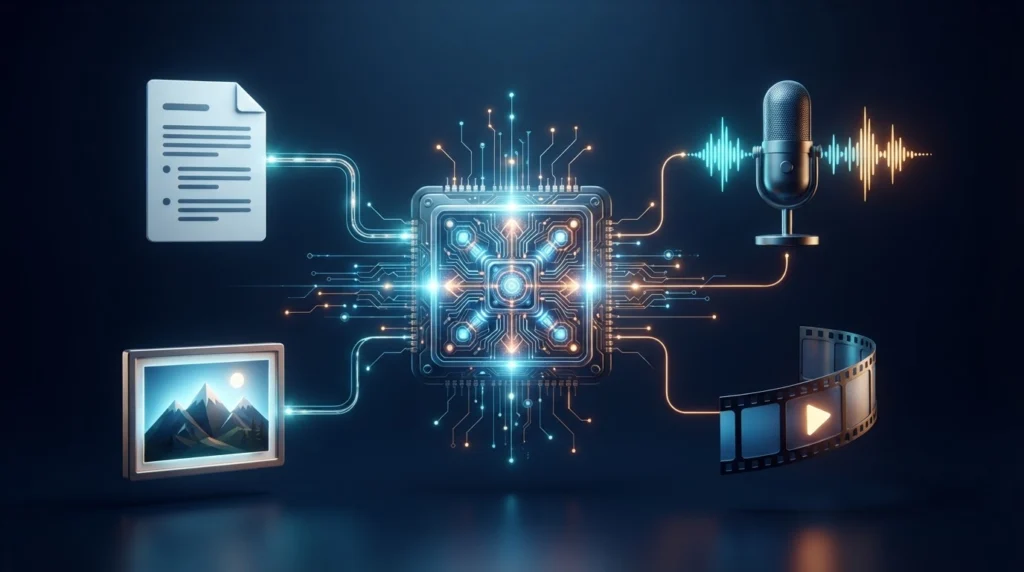
Reprezentare conceptuală a unui model AI care procesează text, imagini, audio și video.
Până de curând, multe aplicații de inteligență artificială erau construite în jurul unui singur tip de informație: primeau text și returnau text. Modelele multimodale pot lucra cu mai multe forme de conținut în aceeași interacțiune: text, fotografii, capturi de ecran, înregistrări audio, clipuri video sau documente. Asta le permite să răspundă la întrebări despre o imagine, să rezume o înregistrare, să descrie o secvență video ori să combine informații din mai multe surse. În acest ghid explicăm ce înseamnă AI multimodal, cum funcționează la nivel practic, unde este utilă și de ce rezultatele trebuie verificate.
Ce înseamnă AI multimodal?
Termenul multimodal descrie un sistem care poate procesa sau genera mai multe tipuri de date, numite modalități. În cazul inteligenței artificiale, cele mai întâlnite sunt textul, imaginea, sunetul și video. Un model multimodal poate primi, de exemplu, o întrebare scrisă împreună cu o fotografie și poate formula un răspuns care ține cont de ambele.
Un sistem care lucrează numai cu text este numit, în sens larg, unimodal. Un model multimodal extinde interacțiunea dincolo de text, dar asta nu înseamnă că toate modelele acceptă toate formatele sau că le procesează la fel de bine. Capabilitățile diferă în funcție de model, versiune, aplicație și metoda prin care sunt trimise fișierele.
De exemplu, un utilizator poate încărca o fotografie și poate întreba ce obiecte se văd, poate trimite o înregistrare pentru transcriere sau poate solicita un rezumat al unui clip. În alte scenarii, textul, imaginea și sunetul sunt analizate împreună, iar răspunsul este formulat într-o singură conversație.
Analiza conținutului nu este același lucru cu generarea lui
Este important să separăm două operațiuni care sunt uneori confundate. Înțelegerea multimodală înseamnă că modelul primește conținut și încearcă să extragă informații din el. Generarea multimodală înseamnă că sistemul creează conținut nou, precum o imagine, o voce sintetică sau un clip video. Unele modele și servicii pot face ambele lucruri, dar funcțiile pot folosi componente și fluxuri diferite.
Dacă îi ceri unui model să descrie o fotografie cu un circuit electronic, îi soliciți analiză vizuală. Dacă îi ceri să creeze o ilustrație nouă cu acel circuit, îi soliciți generare de imagine. Pentru partea de creare vizuală poți consulta separat ghidul Cum generezi imagini cu AI: prompturi, rezultate și limite. Aici ne concentrăm în principal pe modul în care AI interpretează conținutul primit.
Cum ajunge informația dintr-o fotografie, o înregistrare sau un clip la model?
Nu există o singură arhitectură folosită de toate produsele. În unele sisteme, modalitățile sunt transformate în reprezentări numerice compatibile cu modelul principal. În altele, aplicația folosește componente specializate pentru recunoaștere, transcriere sau extragerea cadrelor, apoi transmite rezultatele către un model lingvistic. Detaliile diferă, iar furnizorii nu publică întotdeauna toate etapele interne.
Pentru utilizator, fluxul poate părea simplu: atașează un fișier, scrie o întrebare și primește un răspuns. În spatele interfeței pot exista însă operațiuni de redimensionare, segmentare, extragere a caracteristicilor, transcriere, eșantionare a cadrelor și combinare a contextului. De aceea, limitele de format, dimensiune, durată și rezoluție trebuie verificate în documentația instrumentului ales.
Text: instrucțiunea și contextul întrebării
Textul poate explica ce dorește utilizatorul, poate oferi context și poate preciza ce trebuie urmărit în celelalte fișiere. De exemplu, întrebarea „Compară etichetele din aceste două fotografii și spune ce diferențe observi” stabilește sarcina, iar imaginile furnizează materialul care trebuie analizat. O instrucțiune precisă ajută, dar nu poate compensa o fotografie neclară sau informațiile care lipsesc.
Imagini: obiecte, text vizibil și relații în scenă
Un model cu funcții de viziune poate descrie obiecte, poate răspunde la întrebări despre o fotografie și poate încerca să citească textul vizibil. În funcție de instrument, poate analiza și capturi de ecran, diagrame, grafice sau pagini de document. Documentația OpenAI descrie folosirea imaginilor ca intrare pentru analiza conținutului vizual, iar documentația Google Gemini prezintă sarcini precum descrierea, clasificarea și întrebările despre imagini.
Totuși, recunoașterea vizuală nu este o măsurătoare garantată. Un model poate confunda componente asemănătoare, poate interpreta greșit un text mic sau poate să nu observe un detaliu aflat la marginea cadrului. Pentru identificări tehnice, verifică rezultatul cu fotografia originală și cu documentația echipamentului.
Audio: vorbire, sunete și conversații
Un sistem care acceptă audio poate transcrie vorbirea, poate rezuma o înregistrare, poate răspunde la întrebări despre conținutul ei sau poate participa la o conversație vocală. Unele fluxuri sunt orientate către transcrierea unui fișier, altele către traducere, generarea vorbirii sau conversații în timp real. Aceste funcții nu sunt identice și pot avea cerințe tehnice diferite.
Calitatea înregistrării contează. Zgomotul de fundal, ecoul, mai multe persoane care vorbesc simultan, accentele și termenii tehnici pot afecta transcrierea. Dacă rezumatul unei ședințe conține o decizie importantă, verifică formularea în înregistrarea originală înainte să o transformi într-o sarcină sau într-o instrucțiune oficială.
Video: succesiunea cadrelor și contextul în timp
Video adaugă o dimensiune importantă: ordinea și desfășurarea evenimentelor. Un sistem poate analiza anumite cadre, poate descrie acțiuni, poate răspunde la întrebări despre un clip sau poate indica momente relevante, dacă instrumentul oferă această funcție. Documentația Google pentru înțelegerea video descrie analiza clipurilor, extragerea informațiilor și referirea la marcaje temporale.
Nu presupune că modelul urmărește fiecare cadru la rezoluția originală. Unele sisteme folosesc eșantionarea cadrelor sau limitează durata și dimensiunea fișierului. Un eveniment foarte scurt, un text care apare pentru o fracțiune de secundă sau o mișcare rapidă poate fi omis. Pentru verificarea unui moment exact, cere indicarea intervalului temporal și compară răspunsul cu înregistrarea.
Documente: text, pagini și elemente vizuale
Un PDF poate conține text selectabil, fotografii, tabele, diagrame sau pagini scanate. Unele aplicații extrag textul, altele pot analiza și aspectul vizual al paginilor, iar unele combină metodele. Rezultatul depinde de calitatea scanării, de structura documentului și de funcțiile efectiv suportate de model.
Dacă vrei ca un asistent să răspundă folosind o colecție de documente, este util să înțelegi și tehnica RAG. Ghidul RAG explicat: cum folosește AI documentele tale prezintă separat căutarea fragmentelor relevante și furnizarea lor ca informație de context. RAG și multimodalitatea se pot combina, dar nu sunt același lucru.
Ce poți face practic cu un model multimodal?
Utilitatea depinde de sarcină și de calitatea fișierelor. Câteva exemple arată diferența dintre o conversație text obișnuită și o interacțiune care folosește mai multe tipuri de conținut.
- Analiza unei fotografii: atașezi o imagine și întrebi ce obiecte sunt vizibile, ce text se poate citi sau ce diferențe apar între două variante.
- Înțelegerea unei capturi de ecran: trimiți o captură cu o eroare și ceri explicarea mesajului, fără să presupui că modelul poate diagnostica sigur cauza doar din imagine.
- Rezumatul unei înregistrări: atașezi audio și soliciți transcrierea, ideile principale sau o listă de subiecte care trebuie verificate.
- Analiza unui tutorial video: ceri identificarea etapelor, a obiectelor folosite și a momentelor în care apare o anumită acțiune.
- Combinarea mai multor surse: furnizezi o fotografie, o descriere scrisă și o înregistrare audio, apoi întrebi ce informații se confirmă reciproc și ce rămâne neclar.
În toate aceste situații, formulează sarcina astfel încât să poți verifica rezultatul. Cere modelului să separe observațiile directe de presupuneri și să indice ce nu poate determina din materialul primit.
Exemplu de lucru: analizează o imagine și o înregistrare audio
Imaginează-ți că ai o fotografie cu un panou de control și o înregistrare în care o persoană descrie o problemă. Dacă instrumentul folosit acceptă ambele tipuri de intrare în aceeași cerere, poți furniza fișierele împreună cu o instrucțiune clară. Nu cere direct un diagnostic definitiv; solicită mai întâi extragerea informațiilor verificabile.
Analizează fotografia și înregistrarea audio. În fotografie, descrie numai elementele pe care le poți observa. Din înregistrare, extrage simptomele relatate și formulările relevante. Separă observațiile vizuale de informațiile spuse de persoană, indică neconcordanțele și enumeră ce informații suplimentare ar trebui verificate. Nu presupune cauza problemei dacă materialele nu o demonstrează.
Acest tip de cerere este mai util decât o întrebare vagă precum „Ce este în neregulă?”. Modelul primește o sarcină delimitată, iar utilizatorul poate verifica separat fotografia, înregistrarea și concluziile. Dacă instrumentul nu permite trimiterea ambelor fișiere simultan, analiza poate fi făcută în pași separați, cu păstrarea contextului relevant.
AI multimodală, RAG, agenți AI și generare de imagini: diferențele
Aceste concepte se pot întâlni în aceeași aplicație, dar descriu funcții diferite:
- Multimodalitatea descrie tipurile de informații pe care sistemul le poate primi sau genera, precum text, imagine, audio și video.
- RAG descrie o metodă prin care aplicația caută informații într-o colecție de documente și le oferă modelului drept context.
- Un agent AI folosește un model, instrucțiuni și instrumente pentru a parcurge pași către un obiectiv, în limitele permisiunilor acordate.
- Generarea de imagini produce o imagine nouă sau modifică una existentă, în loc să se limiteze la descrierea ei.
Un agent poate primi o fotografie, poate căuta informații într-o bază de documente prin RAG și poate folosi rezultatul pentru a pregăti un răspuns. Pentru a înțelege partea de automatizare, citește și articolul Agenți AI: ce sunt, cum funcționează și când merită folosiți.
De ce nu toate modelele AI pot analiza orice fișier?
Eticheta „multimodal” nu reprezintă o listă universală de funcții. Un model poate accepta imagini, dar nu și fișiere audio. Altul poate transcrie audio, fără să analizeze video. Unele servicii permit intrări combinate, în timp ce altele solicită conversia fișierelor sau folosirea unor endpoint-uri separate.
Înainte să alegi un instrument, verifică documentația modelului și a aplicației. Caută tipurile de fișiere acceptate, dimensiunea maximă, durata permisă, limitele de rezoluție, limbile suportate, posibilitatea de a trimite mai multe fișiere și dacă răspunsul poate include marcaje temporale sau trimiteri către pagini și fragmente.
Unele funcții sunt disponibile numai prin API sau în anumite planuri. O demonstrație dintr-o aplicație nu garantează că aceeași funcție poate fi integrată într-un program propriu. Verifică și dacă procesarea are loc în cloud sau local, ce costuri pot apărea și cât timp sunt păstrate fișierele.
Limite și erori pe care trebuie să le verifici
Text mic, fotografii neclare și diagrame complexe
Un model poate omite caractere, poate confunda cifre sau poate interpreta greșit o diagramă. O fotografie înclinată, întunecată sau comprimată poate reduce calitatea analizei. Pentru informații precum serii de produs, valori de măsurare, coduri sau etichete, verifică textul în fișierul original și nu copia automat răspunsul în documentația tehnică.
Accente, zgomot și mai multe voci în audio
Transcrierea poate pierde cuvinte, poate atribui greșit replicile sau poate interpreta incorect un nume propriu. Ascultă secvențele importante și corectează textul înainte de a-l folosi ca proces-verbal, dovadă sau instrucțiune.
Evenimente scurte și context temporal în video
Dacă analiza folosește doar anumite cadre, un detaliu care apare foarte puțin timp poate să nu fie observat. Cere marcajul temporal al secvenței relevante și verifică înregistrarea. Nu presupune că un rezumat surprinde toate acțiunile sau toate excepțiile din clip.
Răspunsuri convingătoare, dar nesusținute
Un model poate completa golurile cu presupuneri și poate prezenta o interpretare ca pe un fapt. Cere separarea observațiilor de inferențe și verifică afirmațiile importante în materialul original. Pentru o metodă mai amplă, folosește ghidul Cum verifici informațiile generate de AI și cum depistezi halucinațiile.
Confidențialitate și siguranță când încarci fotografii, audio sau video
Fișierele multimedia pot conține mai multe informații decât par la prima vedere: chipuri, voci, nume, adrese, ecrane cu date personale, documente de lucru sau detalii despre spații private. Înainte să încarci un fișier, verifică dacă ai dreptul să îl folosești și dacă persoanele surprinse au fost informate atunci când este necesar.
Nu încărca parole, chei API, documente confidențiale sau înregistrări sensibile într-un serviciu fără să înțelegi condițiile de utilizare, setările de păstrare și opțiunile de control al datelor. Pentru proiecte de firmă, folosește numai instrumente aprobate și respectă regulile interne privind accesul la informații.
Tratează și conținutul din fișiere ca pe o sursă care trebuie verificată. O imagine sau o înregistrare poate conține text malițios ori instrucțiuni menite să influențeze modelul. Conținutul atașat trebuie analizat în limitele cererii utilizatorului, nu urmat automat ca instrucțiune de sistem.
Cum alegi un instrument multimodal potrivit?
Începe de la sarcina reală, nu de la numele modelului. Dacă ai nevoie doar de transcriere, caută un flux dedicat pentru audio. Dacă trebuie să descrii fotografii, verifică funcția de analiză vizuală. Pentru clipuri, confirmă suportul pentru înțelegerea video și limitele de durată. Dacă ai nevoie de mai multe tipuri de intrare în aceeași cerere, verifică explicit această posibilitate.
- Compatibilitate: acceptă tipul de fișier și combinația de modalități de care ai nevoie?
- Calitate: cum se comportă pe exemple reale, inclusiv pe fișiere dificile?
- Limite: ce dimensiuni, durate, limbi și rezoluții sunt permise?
- Confidențialitate: unde se procesează datele și cât timp sunt păstrate?
- Cost: există tarifare în funcție de text, imagine, durată audio, video sau volum de utilizare?
- Integrare: funcția este disponibilă în aplicația pe care o folosești sau numai prin API?
- Verificare: poți revedea fișierul original și poți identifica pasajele care susțin răspunsul?
Dacă vrei să înțelegi rolul hardware-ului în aplicațiile care folosesc accelerare grafică, poți consulta și explicația Ce înseamnă GPU. Este o lectură complementară despre procesarea grafică; nu înseamnă că orice aplicație multimodală are nevoie de o placă video puternică, deoarece multe servicii procesează fișierele pe serverele furnizorului.
Documentație oficială pentru aprofundare
Funcțiile se schimbă în timp și pot diferi între modele. Pentru limitele actuale, formatele acceptate și exemplele tehnice, consultă documentația furnizorului înainte de integrare:
- OpenAI – Images and vision: analizarea imaginilor și folosirea intrărilor vizuale.
- OpenAI – Audio and voice: transcriere, traducere, generare vocală și conversații audio.
- Google Gemini – Image understanding: transmiterea și analizarea imaginilor.
- Google Gemini – Audio understanding: analizarea fișierelor audio și generarea răspunsurilor text.
- Google Gemini – Video understanding: analiza clipurilor video și identificarea momentelor relevante.
Primul test multimodal ar trebui să fie simplu și ușor de verificat
AI multimodală extinde modul în care putem interacționa cu informația: nu mai este nevoie ca totul să fie transcris sau descris manual înainte de a pune o întrebare. Poți lucra direct cu fotografii, înregistrări și clipuri, în măsura în care instrumentul ales le acceptă. Dar flexibilitatea nu înseamnă infailibilitate. Începe cu un fișier fără date sensibile, formulează o cerere precisă și compară răspunsul cu sursa originală. Astfel vei vedea ce poate face modelul în mod real și unde este necesară verificarea umană.
Descoperă mai multe la Scoala IT
Abonează-te ca să primești ultimele articole prin email.